
在人工智能波澜壮阔的历史里,刚刚过去的 2025 年会被记作具身智能(Embodied AI,也就是与物理世界交互的那一类 AI)的具身智能的「觉醒之年」。
如果把 2018 年以来 Transformer 和大语言模型的爆发理解为「把人类知识变成逻辑、造出一颗数字大脑」,那么 2025 年的技术跃迁指向的是一个更核心的事实:具身智能的本质,是把复杂的数据压缩成简单的格式,用语言或其他形式「思考」,最终「生成」出物理动作。
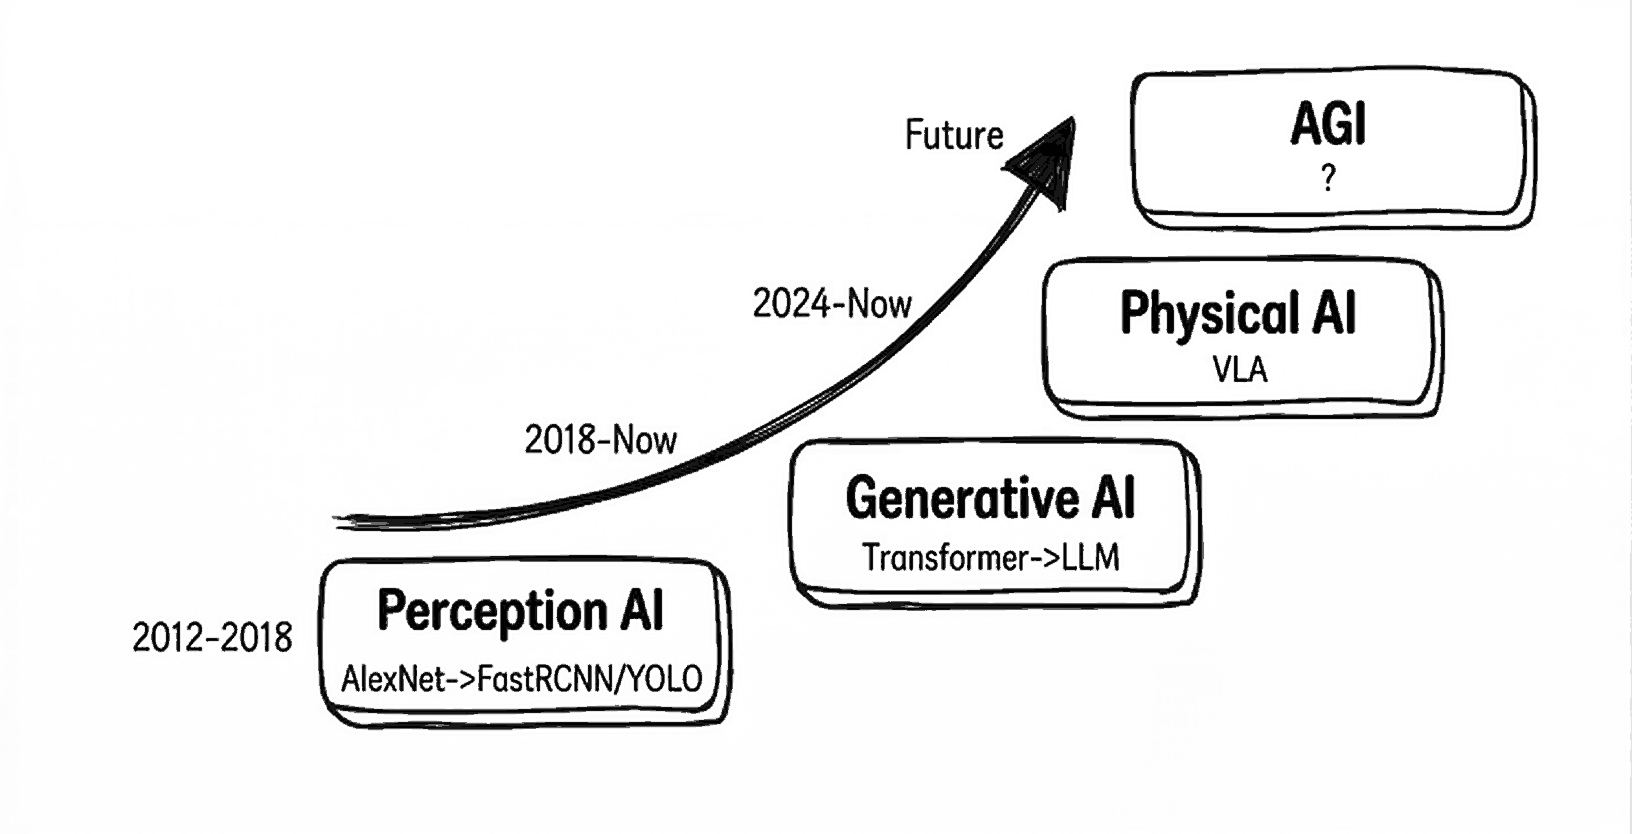
而在一个观点极度分化、市场情绪高涨的年代,VLA(Vision-Language-Action,视觉-语言-动作模型)和世界模型这两条极具潜力的技术路线,却因为基本想法「太好理解」,被卷进了一场公共辩论。
有人断言 VLA 已经是完美现实,有人认定 VLA 毫无用处;有人嘲笑 VLA 是「愚蠢的设计」,也有人担心依赖语言会成为 VLA 2.0 的拦路石;甚至还有一种观点认为,VLA 和世界模型之间必须二选一。
站在 2026 年的起点,我们需要把过去一年的混乱争论理一理:VLA 和世界模型不是互斥的选择,而是 AI 对世界的理解不断加深所走出的两条不同路径。 这篇文章想回到最基本的地方——具身智能究竟是如何从「严格遵循规则」走到「真正理解环境」的。
一、具身智能的三个阶段
Rich Sutton 在那篇著名的《苦涩的教训》(The Bitter Lesson)里指出过一个很深的规律:在足够长的时间尺度上,依赖海量算力和数据的通用方法,最终总会击败依赖人类知识的专用方法。
这条规律在文本和图像 AI 上被验证得相当彻底,但在自动驾驶和机器人领域,这一步跃迁却困难得多、缓慢得多。
具身智能的历史,说到底就是人类不断追求「更高效的数据压缩、更通用的思考、更准确的物理生成」的历史。
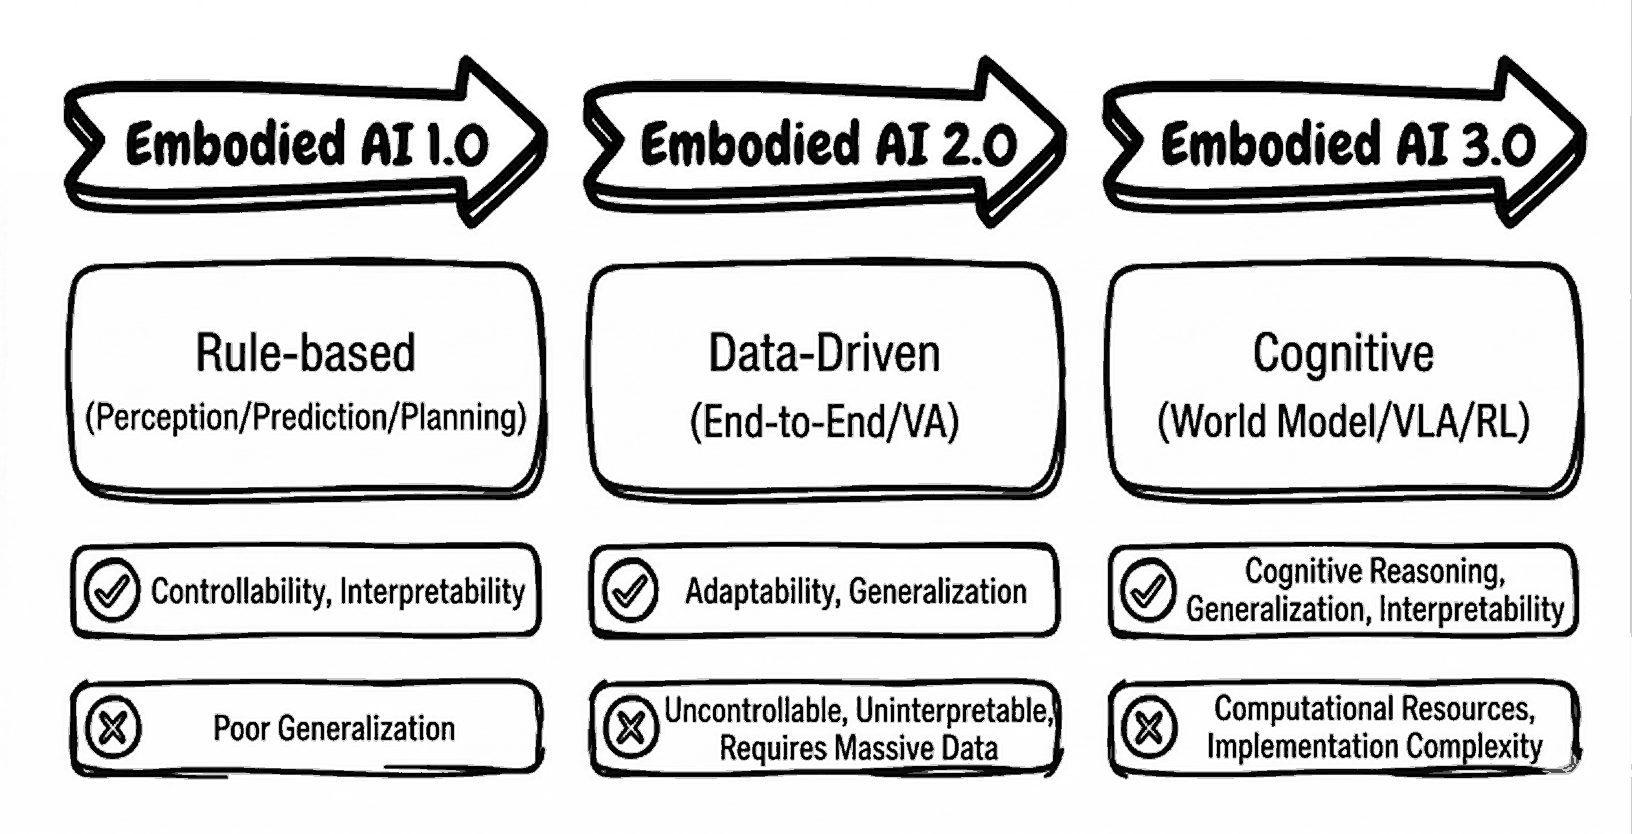
1.1 具身智能 1.0:规则驱动
很长一段时间里,自动驾驶和机器人依赖的是精确的数学模型和物理模型。经典的自动驾驶系统(感知 → 预测 → 规划,即 see, predict, plan),配上传统控制算法(PID、MPC 之类),构成了整个技术底座。工程师花几十年手工设计规则和物理模型,反复调参,只为了让机器沿着既定路径完美行驶。
这套方法在高度有序的环境里几乎无可挑剔。但当汽车开进一座陌生的城市、机器人走进一间杂乱的厨房或堆满货物的仓库,它的弱点就暴露无遗。
物理世界是混乱且不可预测的:摩擦力的突变、传感器数据的噪声、人类行为的意外,都会让手工设计的模型几乎不可能覆盖每一个罕见场景(corner cases)。任何一个没见过的物体、任何一种新的光照条件,都足以让一个平时可靠的系统当场失手。
1.2 具身智能 2.0:数据驱动
随着算力、模型和数据一起变大,自动驾驶和机器人领域全面转向「端到端」学习:试图用数据教会机器像人一样行动、应对新情况。
我有幸在 2018 年的 Lyft 探索过两段式端到端自动驾驶模型,在 2021 年的 Wayve 探索过单段式端到端模型。这类方案通常被称为「视觉-动作」(Vision-Action,VA)模型,它们试图把摄像头输入直接接到物理控制上,跳过复杂的中间环节。Wayve、Tesla(FSD)这类公司,以及 ACT 这样的机器人算法,都做出过惊艳的演示——但总觉得「少了点什么」。
第一,靠模仿人类学习,一旦情况变了就不行。
训练数据大多来自完美的专家驾驶,一旦系统自己出错了、进入了陌生状态,它就无法自我纠正,反而常常会做出更疯狂的动作,让错误一路放大直到彻底失败。这就是我始终相信的那件事:不能练习修正自己错误的模仿学习,最终一定会撞墙。
第二,模仿学习本质上只是在复制人类数据里的规则、常识和价值观。
纯粹数据驱动的模型够不到真正的人类智能,也很难适应新东西。而且机器人的数据采集比从互联网上抓文本难得多,加上机器人形态千差万别,A 机器人的数据很难直接用在 B 机器人身上。
1.3 具身智能 3.0:认知驱动
为了突破数据驱动方法的天花板,研究者开始把预训练好的视觉-语言模型(VLM)当成「大脑」,把它们掌握的海量知识与逻辑迁移到物理控制上——VLA 模型就此诞生。
我也很幸运在 2023 年初参与过早期 VLA 在自动驾驶方向的探索,做过 Wayve 的 Driving-with-LLMs 和 Lingo 项目;差不多同一时期,机器人领域也出现了 RT-2 这样的经典框架。
VLA 不只是 VA 的升级版:它把「看到就反应」的简单方法,改造成了一个认知决策系统——用大模型理解多种类型的数据,向前推演若干步,再生成动作。
回头看 2025 年,多数专家都会认同一件事:用互联网规模的语料训练,让 VLA 获得了理解世界、使用常识、听懂指令的强大能力。
举个例子,VLA 能轻松理解「把那个看起来像苹果的红色物体拿给我」这条指令。即使它从没见过这个具体物体,也会调用学到的「苹果」和「红色物体」知识,结合指令,推演步骤,然后决定怎么动。
虽然「世界模型」这个词在 2025 年被用得有点过了,但生成式世界模型确实是 AI 理解能力的重要一环。语言和视频是互联网上最便宜的两类数据,训练模型去预测视频的下一帧,是让模型长出智能的绝好方式。世界模型在真实场景中仍有不少挑战——比如保持一致性、跑得够快——但我们已经在 VLA 系统里看到了它的影响,下文会说。
二、VLA 本质上是一个「理解 — 推理 — 决策」框架
VLA 起初只是一个学术想法,但往深处看,它其实是一个通用的「理解、推理、决策」框架。
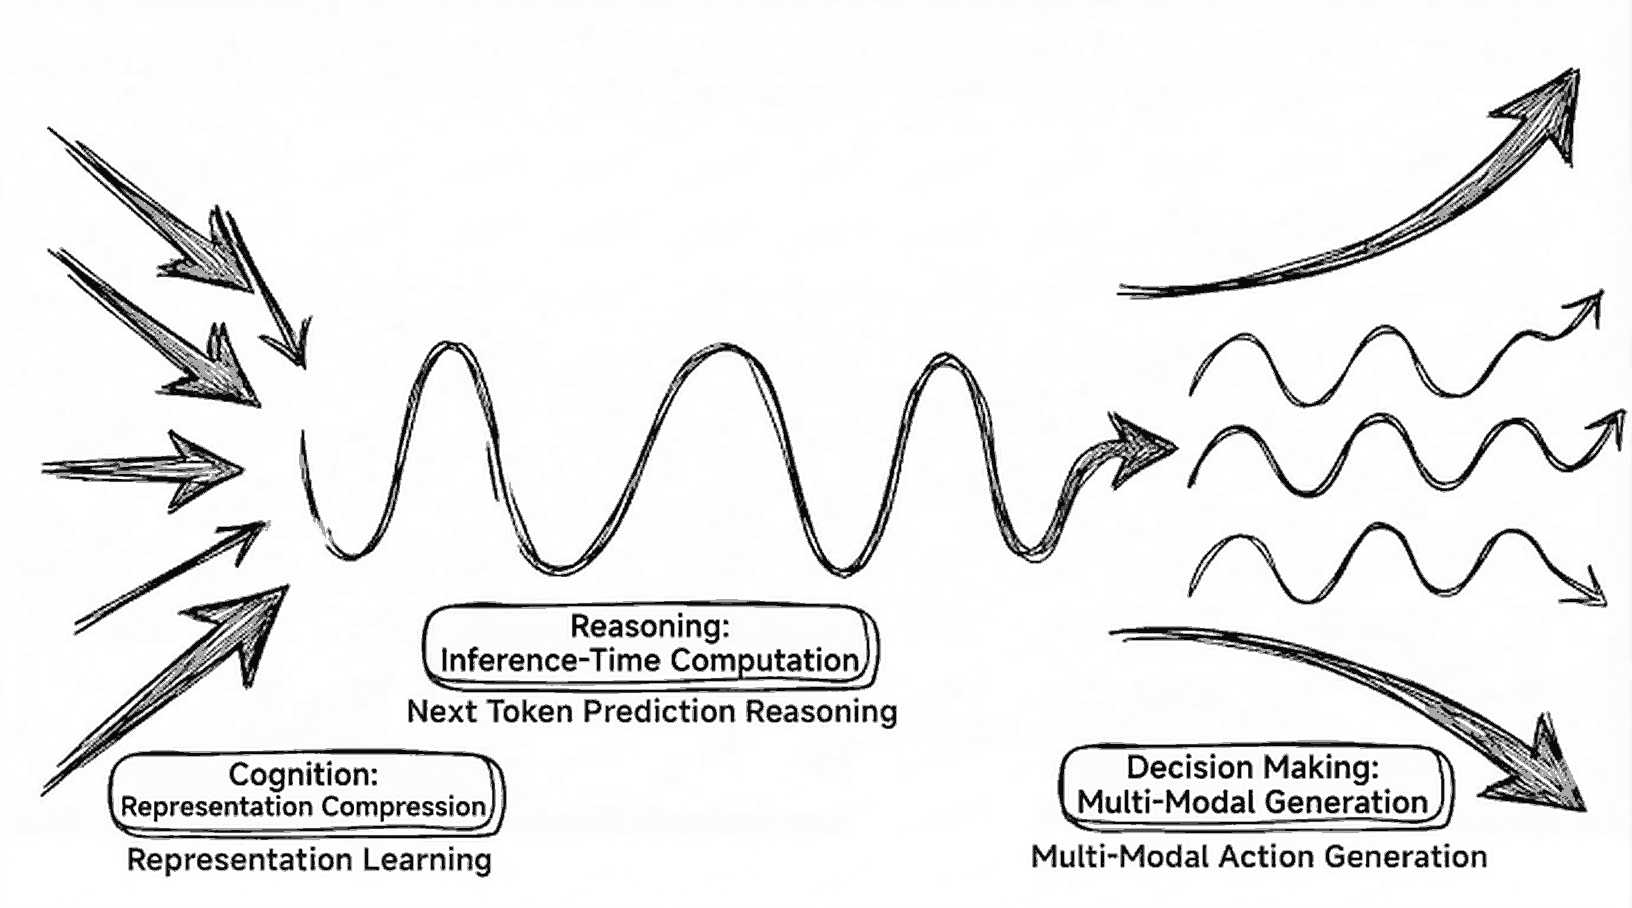
- 理解不只是视觉,而是把各种类型的数据都做简化;
- 思考也不只是语言,虽然语言目前是最容易的思考方式;
- 决策的方法有很多,但行业还没有找到一个能同时兼顾灵活性、速度和精度的完美答案。
2.1 理解:把复杂数据压缩掉
理解的核心是压缩。如何把海量数据(视觉、触觉、深度)压缩成 AI 容易读取的简单格式,是机器学习的一大难题。
- 与语言对齐。 因为机器人数据稀缺,VLA 长期复用语言模型的视觉系统,核心做法是通过图文对比来训练。近期的模型在混合图像与时间(视频)上做得更好,但 VLA 仍需更好地理解时间流动。我们期待 2026 年出现更好的视频处理方式。
- 与空间对齐。 2025 年出现的新 3D 数据格式(比如 3DGS)带来了快速改进,但仍严重依赖人类先验,且难以处理时间流动。自学习方法(比如 JEPA)通过重建隐藏的数据格式,更善于学到物体本身的性质,但这条路依然很难与语言这类人类规则完美对接。
- 世界模型。 通过预测未来,世界模型是极好的训练工具。比如用视频预测来辅助动作规划,已经取得了很好的效果。我们希望今年能看到一个把语言、图像和物理动作完美连接起来的开源模型。
2.2 推理:测试时扩展的力量
VLA 真正的力量在多步的测试时扩展(test time scaling)上,其中就包括用语言来做推理。
- 语言思考。 语言适合复杂任务和陌生场景,本质上是借助 AI 的通用知识来辅助决策。统计上,多想几步能降低不确定性,从而带来更安全的决策。受限于当前的数据和速度,VLA 的思考能力还没被完全释放——现在机器人大多只用语言理解指令,自动驾驶则用它来挑选驾驶模式。但随着数据变好,我们期待 2026 年的 VLA 展现出明显更强的解题能力,就像文本 AI 经历过的那样。
- 视觉思考。 随着 AI 越来越会生成和理解图像,「用图像思考」也开始流行。近期已有多个项目证明,预测未来视频帧能大幅改善规划。但如何从图像里滤掉无用的背景细节、让 AI 思考得更快,仍是一个需要深入研究的方向。
2.3 决策:走向单一、无缝的系统
决策层是把具身智能落到现实世界的最后一步,也是 VLA 与语言 AI 差别最大的地方。2025 年,我们看到了一次从「双脑」系统到高效得多的「单脑」系统的巨大转变。
双进程系统。 在 VLA 的早期(2023—2024),多数方案建立在两部分理论之上:
- 慢脑(系统二):大语言模型充当主脑,负责理解语义、拆解任务、逻辑思考,输出文字指令或大致的路径;
- 快脑(系统一):传统控制算法或简单网络充当「小脑」,依据慢脑的指令快速反应。
问题在于,虽然用上了 AI 的思考能力,但两个大脑之间存在巨大的延迟。这就像一位老练的司机在口头指挥一位新手——无论指令多么精准,这点反应延迟就足以毁掉整体表现。
单模型 VLA。 为了做出一个完美、无缝的流程,2025 年的 VLA 把「思考」和「行动」彻底合并进了同一个模型。这个变化最直观地体现在 AI 输出动作的方式上:
- 类文本动作(离散 token)。 早期的尝试干脆把物理动作转成文字词,这样 AI 就能像学语言一样学动作。缺点是动作不够精确,机器人看起来僵硬而笨拙。
- 平滑的数值预测(连续回归)。 为了解决笨拙问题,后续模型改为直接预测动作的具体数值,控制因此平滑了很多;但当存在多个同样合理的选项时,模型就为难了——比如车可以从障碍物左边绕过去,也可以从右边绕过去,模型却可能一头扎进正中间。
- 流匹配(Flow Matching)。 这是 2025 年初最令人兴奋的突破。π0(pi-zero)这类模型引入流匹配,在保持生成速度的同时轻松处理多种合理选项,动作精度也非常高。后来的模型把它与更快的训练方法、人类纠偏数据结合起来,让机器人的动作达到了前所未有的人类般流畅、力度与安全。
但我们必须诚实:VLA 的最终决策层目前还不完美。
不同任务——快速奔跑的机器狗、缓慢移动的机械臂、自动驾驶汽车——需要不同的设计。行业仍在寻找那个最佳平衡点:一个既能适配任意机器人、又能适应任意新场景,同时速度与精度都拉满的模型。
三、未来展望:2026 及更远的路
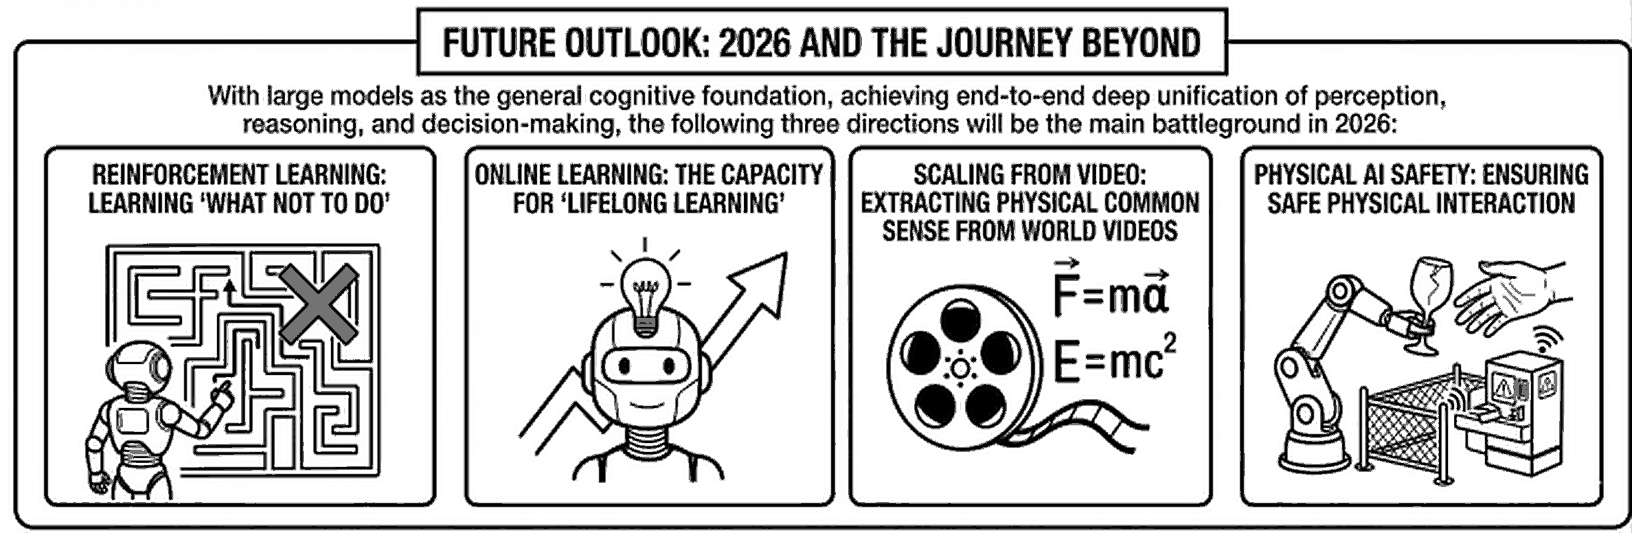
站在 2026 年的起跑线上,具身智能的蓝图已经清晰:用大模型作为主脑,把看、想、做彻底连起来。 除了让 VLA 系统本身更好,2026 年还有四个方向值得重点关注。
3.1 强化学习:学会「不做什么」
如果模仿人类是在教机器人「该做什么」,那么强化学习(在试错中学习)教的就是「不做什么」。
因为优质的机器人数据稀缺,试错才是突破人类样本上限的关键。未来的模型需要在安全的数字仿真器或受控的真实区域里练习,通过不断的犯错与纠正,学会物理的边界、严格的安全规则,以及如何应对极其罕见又危险的情况。
3.2 终身学习
一台已经部署的机器人或自动驾驶汽车,不应该停止学习。真正智能的机器,必须能一边与世界交互,一边学习。
目前大多数模型是在实验室里离线训练好的,现实一变就冻住不动。2026 年,我们会看到更多「边干边学」的模型:它们用自身的记忆和实时数据更好地理解用户想要什么,从而实现真正的终身学习。
3.3 从视频学习:获得物理常识
互联网上最便宜的两类数据是文本和视频。AI 已经基本掌握了文本,下一次大的跃迁会来自视频,而世界模型在这里将扮演关键角色。
通过观看海量的人类视频和行车记录仪片段,AI 会自然而然地学到物理规律——重力、动量,以及东西撞上之后会发生什么。让 AI 通过「猜下一帧」来认识世界,等于给它装上一个心理模拟器;它可以用这份想象力,在真实世界里行动之前先安全地演练一遍。
3.4 物理 AI 的安全
当 AI 从模仿完美的专家数据,转向从开放互联网(视频、文本、图像)里学习时,一个巨大的新挑战出现了:如何让 AI 从互联网学习,又不被假内容带偏,同时严格遵守人类的安全规则?
互联网上充满了抽象的文字、幻想故事、电影 CG、卡通,以及彻底违背物理规律的 AI 生成视频。随着 AI 从这类数据中变得越来越聪明,我们必须保证它只学到真实的物理,并且做出与人类意图和社会规则高度一致的安全决策。
结语
2026 年,是我们深入探讨自动驾驶、机器人与大模型三者融合的一年。此刻,行业和研究者需要的是忽略炒作,聚焦 VLA 与世界模型的基本事实,去实地检验这些模型在真实世界里究竟能有多聪明。
把真正的智能带进物理世界,是通往通用物理 AI(General Physical AI)的必经之路。
我们共同期待的那种通用的人工智能,或许就在下一个转角。
NOTE
本文为翻译,原文链接:VLA and World Models: Embodied AI Awakened(发布于 2026 年 3 月 16 日)。插图亦来自原文。